哥伦比亚大学COMS W4995 Agentic Engineering2026年10月2日

假学习的终结

当“做完”不再证明“学会”

假学习的终结▶ 播放幻灯片

你受过的所有教育,都悄悄依赖着一个前提:做完了,就说明你学会了。

老师按这个打分,公司按这个招人,你自己也按这个判断自己有没有进步。

AI打破了这个前提。你能做完的,它现在都能替你做完。所以我想回答一个我们很少被逼着回答的问题:学会,到底是什么?为什么学习常常让人感觉是反的?

哥伦比亚大学Agentic Engineering课的客座分享 · 读完约15分钟

01什么是学会看这一页幻灯片 ↗

分数看的是结果,学习发生在过程里

先想一件事:你交过的任何一份作业,如果当时是抄的,答案一样,分数一样,成绩单分辨不出来。但你什么都没学到。

原因很简单:分数看的是结果,学习发生在过程里。在第三题卡一个小时,试一个错的方法,搞明白它为什么错,这些都在过程里。抄作业,结果还在,过程没了。

结果分数看得见过程学习发生的地方,分数看不见
把作业做一遍一个分数学到的东西
抄一份作业一样的分数什么都没有
结果一样,分数一样。过程没了,学习也没了。

过去,结果和过程总是一起出现,因为拿到结果最现实的办法,就是自己走一遍过程。所以我们很少需要问:学会到底是什么?这个问题一直有人替我们回答:老师,还有分数。

AI来了以后,作业和项目都可以由AI做出来,分数就回答不了这个问题了。你得自己回答。

01什么是学会看这一页幻灯片 ↗

真正学会,是撤掉帮助、过一段时间、换一道题,你还会

学习科学里有一个经典区分:表现和学习。⁠1

表现,是你当下做得怎么样:练习的时候,或者刚做完的时候,身边通常还有帮助。学习,是过后还剩下什么:帮助撤掉了,时间过去了,题目也换了。

  1. 01 · 撤掉帮助不用AI,不看笔记,不照教程。
  2. 02 · 过一段时间一周以后,不是刚做完。
  3. 03 · 换一道题换一批输入,加一个约束。
有帮助、刚做完、同一道题上做得好,叫表现。

所以我想请大家记住这个定义:真正学会,是撤掉帮助、过一段时间、换一道题,你还会。

除此之外的,都是表现。假学习,就是把表现当成了学习:把“做出来了”,当成“学会了”。

这就带来一个很现实的问题:如果学会要过一段时间才看得出来,那学的时候,我们靠什么判断自己学会了没有?

02为什么反着看这一页幻灯片 ↗

先猜:哪一组学得更多?哪一组觉得自己学得更多?

靠感觉。那我们就来测一下你的感觉。

哈佛在一门物理入门课上做过一个随机实验。⁠2内容完全一样,讲义也一样。A组听一位好评很高的老师讲课,讲得清清楚楚。B组分小组自己做题,卡住了,再听讲解。

A组

一位好评很高的老师,讲得清清楚楚。

B组

分小组自己做题,卡住了,再听讲解。

01哪一组在测验里学得更多?

02哪一组觉得自己学得更多?

02为什么反着看这一页幻灯片 ↗

学会的感觉和学会,常常是反着的

自己做题的B组,和听讲的A组相比

看数字
A · 听讲B · 自己做
真的学到(测验成绩)更少更多 · +0.46 SD
觉得学到(自我评价)更多更少 · −0.56 SD

SD:标准差。Deslauriers等,PNAS,2019。⁠2

两道题都猜完再看,或者。

自己动手的B组,测验成绩明显更好,却觉得自己学得更少。听讲的A组学得更少,却觉得学得更多,还希望所有物理课都这样上。

顺利,让人以为自己学会了;吃力,让人以为自己没学会。真相常常相反。研究者的解释是:自己做题多出来的那份吃力,被学生误读成了没学好,而它恰恰说明学习正在发生。

这跟我们教AI课的观察很吻合。我们很注重给大家“guided mistakes”,但它会让学员烦躁、有挫败感,甚至觉得这门课教得不好。反而越顺畅的课,学员观感越好。可上完课,很容易只记得一个感受,没有真的学进去。

那为什么吃力反而学得更多?

02为什么反着看这一页幻灯片 ↗

错得越多,学得越多

因为学习发生在你的想法和现实对不上的时候。

  1. 01先猜一个答案。
  2. 02猜错了。
  3. 03去想为什么错。
  4. 04原来的想法被改掉。

你先猜一个答案,猜错了,才会去想为什么错,脑子里原来的想法才会被改掉。如果你从来没猜,就没有对不上,也就什么都没变。

心理学实验一再发现:先自己试着回答,哪怕答错,再看正确答案,比直接看答案学得更牢。⁠3

顺便说一句:刚才猜错的人,会比猜对的人更记得这个结果。这个机制,刚刚就在你身上发生了。

所以,错得越多,学得越多。反过来,顺利的学习,经常是无效的学习。

03AI做对的时候看这一页幻灯片 ↗

AI最危险的时候,是它做对了

明白了这一点,就能看清教程和AI的问题。

  1. 一堂讲得很好的课你在看别人思考。
  2. 一个教程坑都有人替你踩过了。
  3. 一个AI答案你还没卡住,它已经对了。

一个比一个顺利留给你犯错的机会越来越少 →

教程是打磨过的顺利。每一步都有人替你试过,坑都提前填好了,你照着做,一次就成。感觉学得很快,但你从头到尾没有机会错。我以前写过:教程教会你的东西,其实已经不值钱了;它帮你跳过的东西,反而最值钱。

AI是更极致的顺利。你还没开始想,答案已经在屏幕上;你还没卡住,代码已经跑通了。

所以,AI把东西做出来以后,最危险的不是它做错了,而是它做对了,你以为自己也会了。这个“我会了”的感觉,会让你停下来。你不会再自己试一遍,也不会换一道题检验。真学习最需要发生的地方,就这样被跳过了。

有人把这件事量了出来。

03AI做对的时候看这一页幻灯片 ↗

练习做得更好了,学得却更差了

这是一项随机实验,将近一千名土耳其高中生学数学。⁠4练习阶段,一组随时可以问GPT-4。

随时可以问GPT-4的学生,和没用AI的学生相比

他们的练习成绩高了48%。可一到考试,谁都不能用AI,这组学生的成绩反而比从没用过AI的学生低了17%。

练习变好了,学习变差了。同一批人,同样几周。而且在AI被拿走之前,谁也看不出来。

科幻作家特德·姜有个比喻:⁠5用ChatGPT写作文,就像开着叉车进健身房。杠铃举起来了,肌肉没有长。学AI的人尤其要小心:你用来学AI的工具,恰好就是那台叉车。

而且,这件事不只发生在学校。

04假工作看这一页幻灯片 ↗

Fake learning和fake work,骗的是同一个东西:你对“进步”的感觉

这件事,我是在工作里想明白的。

我在腾讯带团队时,主要工作就是上传下达、互相翻译:把老板的战略翻译成下面的动作,再把大家的成果往上汇报。我做得还挺好,老板和下面的人都喜欢我,我也过得很舒服。但我越来越常问自己:我到底有什么进步?我创造了什么价值?
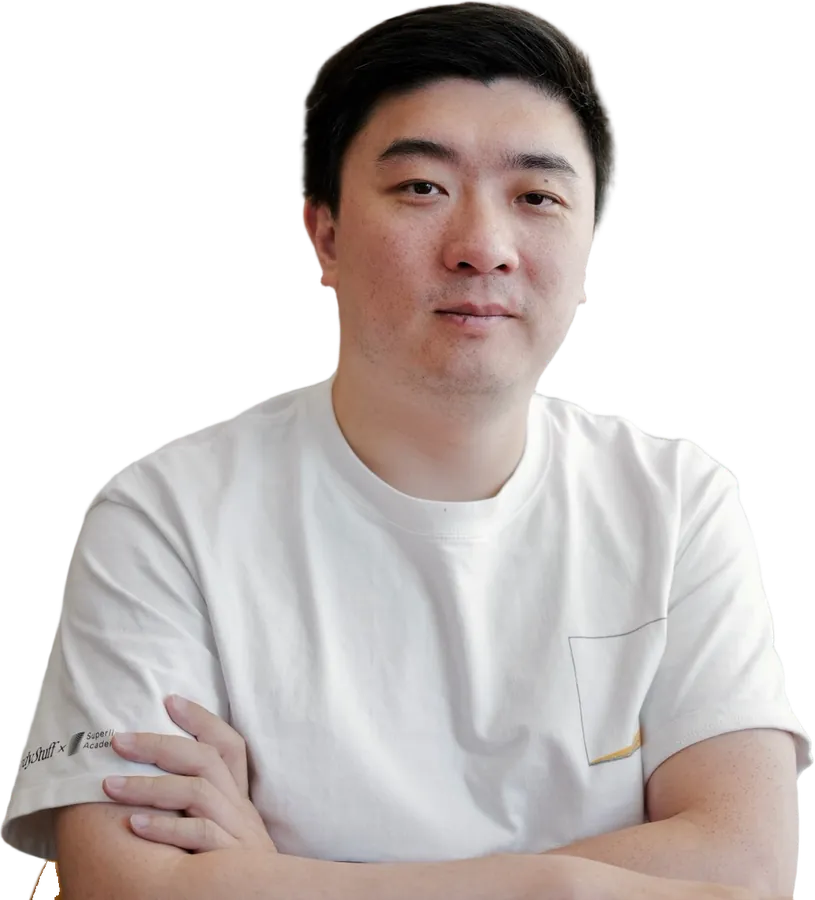
孙煜征,白T恤,抱臂
Fake work用可见的动作,代替难以衡量的价值。
Fake learning用可见的结果,代替难以衡量的成长。

我把这叫fake work:用可见的动作,代替难以衡量的价值。它是结构性的:知识工作的价值很难衡量,组织只好看进度、报告、会议这些看得见的动作,人也就开始生产动作。它最危险的也是那种感觉:开了一天会,累得要命,大脑告诉你今天很努力。事情没有前进,你却有了前进的感觉。

Fake learning和fake work,骗的是同一个东西:你对“进步”的感觉。

这种错觉是被训练出来的。在学校,老师和分数告诉你什么算好;在公司,老板和KPI告诉你什么算好。十几年下来,我们练得最熟的是让打分的人满意,却很少练过自己判断什么是真的好。我们被训练成了对价值不敏感的人。

所以,从假学习里走出来的人,进了公司,会自然而然地做fake work。不是他们不努力,是他们只被训练过这一种努力。

05新的分数看这一页幻灯片 ↗

学会一个新工具最像进步,几个月就过期

在学校,分数是结果。学AI的人也有自己的分数:学会了几个工具,做出了几个原型。

先说工具。学会一个新工具,搭好一个自动化,进步看得见:能截图,能发朋友圈,能写进简历。可AI工具几个月就换一轮。半年后,你熟悉的那些按钮和命令,很多已经不在了。

你攒下的一个新工具、一个自动化、一个学完的教程留下来的习惯、方法和思维方式
进步的感觉马上就有几乎没有
拿得出来吗能截图,能发朋友圈,能写进简历没法截图
半年以后很多按钮已经不在了都还在
学工具最有进步的感觉,却过期最快;养习惯最没有进步的感觉,却一直留在你身上。

留下来的,是看不见的东西:习惯、方法和思维方式。比如,拿到一个模糊的需求,你会先把它拆成能检验的小步;结果不对,你会先找原因,而不是换个工具再试一遍。这些东西没法截图,却不会过期:换一个工具、过一年、换一个问题,它们都还在,正好通过我们开头那个检验。

我培训过几千个科技公司的人,结论越来越明确:同一个模型,有人觉得它不靠谱,有人把它用成了稳定的工作系统。差别不在工具,在方法。

那为什么大家还是爱攒工具?因为工具有一个清楚的“学会了”的时刻,方法没有,它是在做事里一点点长出来的。学工具最有进步的感觉,却过期最快;养习惯最没有进步的感觉,却一直留在你身上。又是反着的。

05新的分数看这一页幻灯片 ↗

原型只需要在展示那一刻是对的,产品要在现实变化时一直是对的

再说原型。有了coding agent,一个下午就能做出一个像模像样的App。可原型最擅长的是顺利的情况:需求清楚,数据简单,用户只有你自己。

原型 · 和agent一起的一个下午

需求清楚。数据简单。用户只有你自己。

产品 · 面对别人

用户输入你没想到的东西。数据会出错。而且你不在旁边。

产品要面对别人。用户会输入你没想到的东西,数据会出错,需求下个月就变;而且用户用的时候,你不在旁边。我在《Don't build》里写过:demo只需要在展示的那一刻是对的,产品要在现实不断变化的时候,一直是对的。

从原型到产品,每一步都是你的想法撞上现实:你以为用户会这样用,结果人家偏偏那样用。很多正确的决定,在看到错误的版本之前,根本不存在。错一次,学一次。

原型让人觉得进步神速,恰恰因为它跳过了最该学的这一段。

所以,AI时代的真学习,常常就在这两段路上:从学会一个工具,到养成一种做事的方法;从做出一个原型,到做成一个产品。

06保护员,不是叉车看这一页幻灯片 ↗

同一个AI,不同的设计,不同的学习

那要不要少用AI?不用。回到那个数学实验,它还有第三组。

先预测一下:同样是GPT-4,但只给提示、不给答案。考试的损失会……

GPT-4的两种用法,和没用AI的学生相比

看数字
GPT-4当叉车GPT-4当保护员
怎么帮你有问必答,直接给答案只给提示,不给答案
练习(有帮助时)+48%+127%
考试(不用AI)−17%没有显著损失

Bastani等,PNAS,2025。⁠4

先在上面选一个,或者。

老师给这个GPT-4提供了标准解法和学生常犯的错误,要求它只给提示,不给答案。练习阶段,这组提升更多:127%。考试时,损失基本消失了。

同一个AI,不同的设计。区别就在于:学生还有没有机会自己先想、自己犯错。

这就是叉车和保护员的区别。叉车替你举;保护员站在你身后,让你自己举,只在你快撑不住的时候托一把。

06保护员,不是叉车看这一页幻灯片 ↗

在关键处,选难的那条路

把AI当保护员,就是在关键处,故意选难的那条路。

但不是所有的难都值得选。那天和我一起讲的鸭哥,把配环境、申请token、调端口这类事叫作“假困难”:它们消耗意志力,给人一种“我在努力”的错觉,却不增长你的智慧。这类事,尽管交给AI。难,要留给真正的问题:这件事值不值得做,该怎么拆,做出来的东西好不好。

假困难 · 交给AI

配环境、申请token、调端口。消耗意志力,不长本事。

真困难 · 留给自己

这件事值不值得做?该怎么拆?做出来的东西好不好?

然后是三步

  1. 先自己猜,再让AI动手。写下你打算怎么做,你觉得哪里会出错,然后再看AI的结果。错了,才有得学。
  2. 撤掉帮助,再做一遍。过一两天,关掉AI,自己重做一遍,或者讲给别人听。卡住的地方,就是还没学会的地方。
  3. 换一道题。改一个条件:换一批数据,加一个约束,换一个用户。看你还会不会。

第一步,让你有机会犯错;后两步,是在检验你学会了没有:撤掉帮助、过一段时间、换一道题,你还会不会。

做的时候,你会觉得更慢、更吃力。那不是退步,是学习在发生。

07还能证明你的看这一页幻灯片 ↗

人人都能用AI做出漂亮的作品,作品就证明不了什么了

换上经济学家的帽子。迈克尔·斯宾塞因为一个大家凭直觉就懂的道理拿了诺贝尔奖:一个信号,只有在难以伪造时才有用。⁠6

你拿得出来的过去说明现在的成本
一篇漂亮的文章你会写。一句提示词。
一份能通过测试的代码你会写代码。一次agent运行。
满满一个GitHub的项目你能做东西。一个周末。

能证明你的,只剩撤掉帮助以后你还会的东西。面试官会不再只问你做了什么,而是问你为什么这样设计,哪里坏过,你会怎么改。

07还能证明你的看这一页幻灯片 ↗

终结的,是一种误会

假学习的终结,不是说分数、证书和教程会消失。它们还会在,也还有用。终结的是一种误会:把做出来了,当成学会了;把顺利,当成进步。

对真心想学的人,这是个好消息。过去,要找一个随时在线、极有耐心、能看出你哪里想错的保护员,几乎不可能。现在它就在你手边。区别只在于,你让它替你举,还是让它看着你举。

你可能注意到了,这一页有两次,我都是先请你猜,再给结果。猜错的那些,恰恰是你最记得住的。

你这个月用AI学会的一样东西,关掉AI、换一道题,还会吗?

学点真本事,做点真东西。

注释

  1. Soderstrom & Bjork,《Learning Versus Performance: An Integrative Review》,Perspectives on Psychological Science,2015。
  2. Deslauriers等,《Measuring actual learning versus feeling of learning in response to being actively engaged in the classroom》,PNAS,2019。随机实验,哈佛物理入门课。
  3. Kornell, Hays & Bjork,《Unsuccessful retrieval attempts enhance subsequent learning》,Journal of Experimental Psychology,2009。
  4. Bastani等,《Generative AI without guardrails can harm learning》,PNAS,2025。随机实验,约1,000名土耳其高中生;变化均相对于没用AI的学生。辅导版使用老师提供的解法和常见错误。
  5. 特德·姜(Ted Chiang),《Why A.I. Isn’t Going to Make Art》,The New Yorker,2024。
  6. 迈克尔·斯宾塞,2001年诺贝尔经济学奖,获奖工作是不对称信息市场的分析(就业市场信号)。

延伸阅读

这场分享用到的我的几篇文章,在Superlinear Academy。

关于这场分享

2026年10月2日,哥伦比亚大学COMS W4995 Agentic Engineering课的客座分享。这一页是把演讲写下来、方便阅读的版本;原幻灯片在这里,也有英文版。

还有问题?

可以去「问问立正」问,回答来自我公开讲过、写过的内容,每条都带出处。

问问立正 →