AI都会教你了,为什么还要上课?
这个问题我躲不开,因为我自己就在教AI课。
而且我得先承认:我课上讲的很多东西,你今天直接问AI,它也能讲清楚。
一个概念是什么,一个工具怎么用,它几秒钟就讲完了,还能拿你的工作举例子。
所以一门AI课,如果还拿“课时多、工具全、体系完整”当卖点,
我觉得它还没认真想过:AI对上课这件事,到底意味着什么。
我的答案是这一句:
AI让答案几乎免费。
一门课要上的,是AI给不了的两样:
水面下的判断,和把它练出来的那股劲。
听着有点抽象。我拿一座冰山,把它拆开讲。
先看水面上。
你看别人用AI,能看到什么?一段提示词,一个工具,一个结果。
再加上网上的教程,还有每个月冒出来的新名词、新框架。
这些东西,一分钟就能抄走。所以抄别人的提示词,几乎从来拿不到别人的结果。
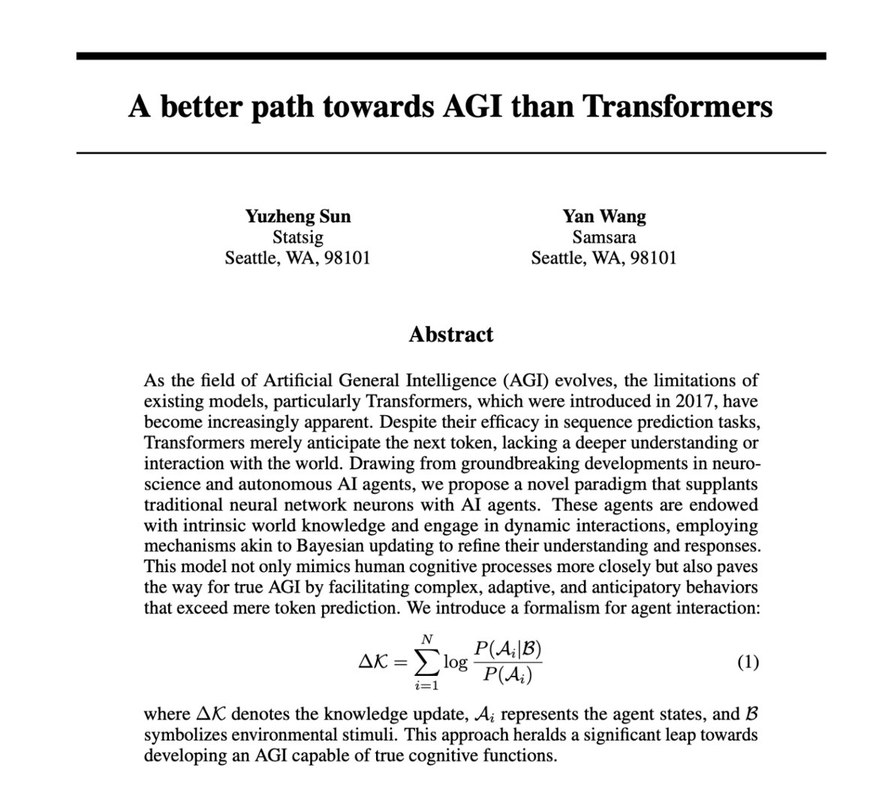
通往AGI的路》
AI还让这一层更便宜了。我在课上做过一个小实验:给学员看一份研究摘要,题目叫《一条比Transformer更好的通往AGI的路》。写得很严肃,很具体,该有的词都有。
我问大家信不信,
然后告诉他们:这是我用ChatGPT做的,大概五分钟。
比我们任何人检查的速度都快。
像样又具体的答案,现在几乎不要钱。
AI做出“看起来懂了”的速度,比我们任何人检查的速度都快。
这一层当然有用。一门课连这些都讲不清楚,没资格谈别的。
可它只是门票。
我之前写过一句话:tutorial教会你的东西,其实是不值钱了。
但tutorial帮你跳过的东西,反而是最值钱的。
跳过的是什么?在水面下。
它会在哪坏
要查什么
为谁做
什么叫好
水面下,是你看不见的判断。我把它分成两种直觉。
一种是技术直觉:该给AI什么,它会在哪坏,要查什么。
另一种是产品直觉:什么值得做,为谁做,什么叫好。
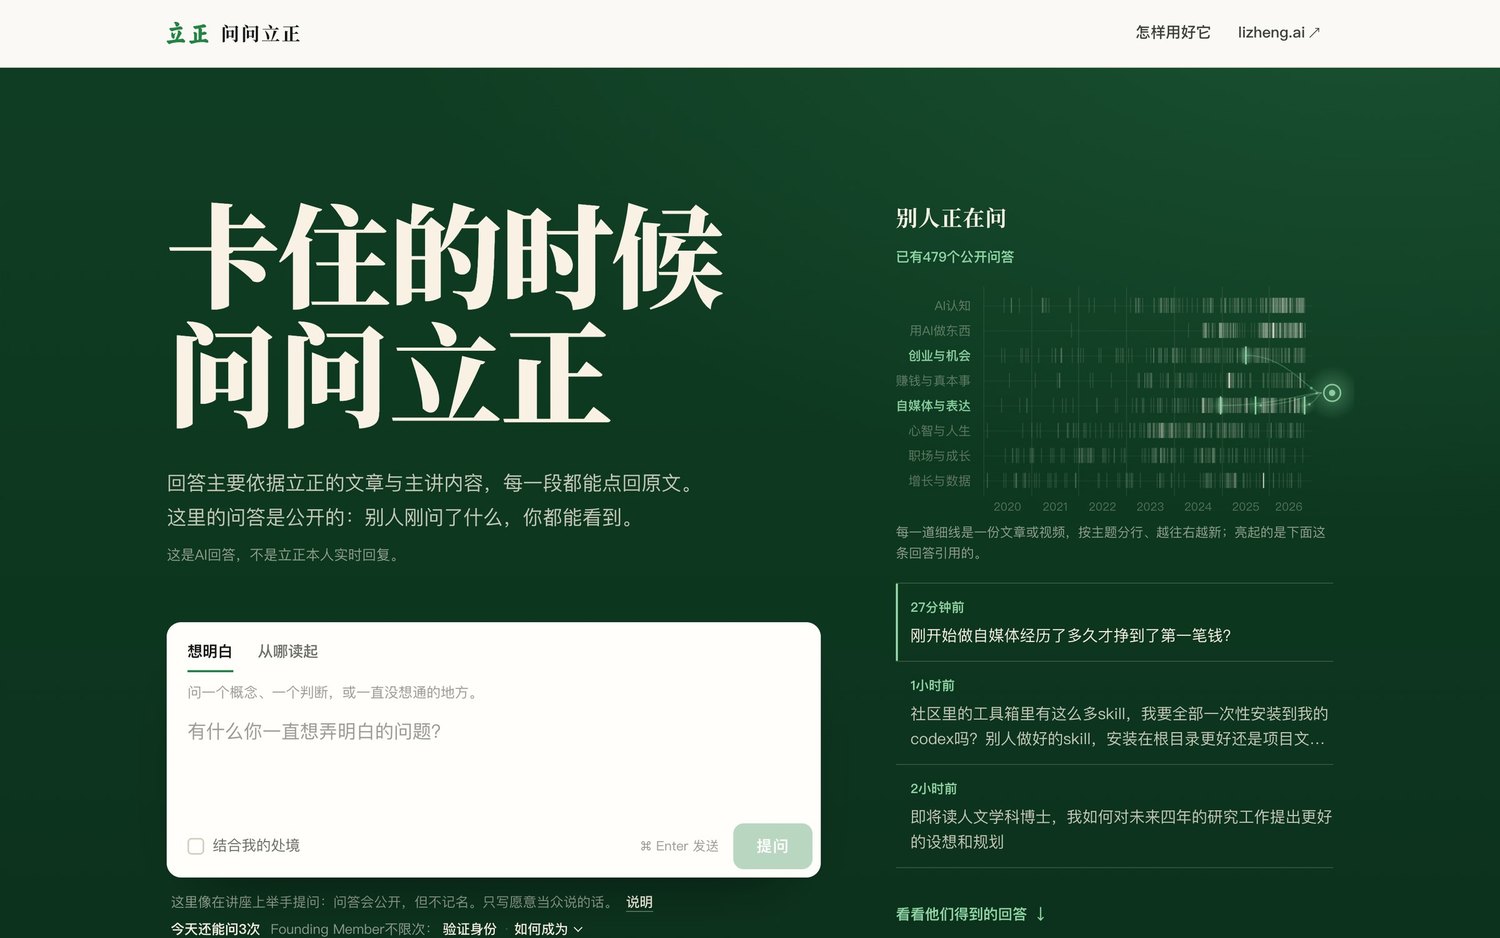
先接着说那些新名词。我做了一个网站叫“问问立正”,你问问题,它从我这些年的视频和文章里找答案,资料将近八百万字。
很多人第一反应是:这得搭一套复杂的检索系统吧?我没搭。
向量就存在一个普通文件里,再加上关键词搜索,效果非常好。
知道一项技术是什么,在水面上。
知道这次不用它,在水面下。
为什么要全部装进内存?
这个网站还有两个故事。有一次,它内存超了:平台给256MB,它要260。
AI给的方案很合理:削一削峰值,再去找鸭哥多要点内存。
我问的是另一个问题:资料本来就在文件里,为什么每次都要全部装进内存?
改完以后,103MB,两秒就绪,结果一模一样。
网站挂了二十分钟
还有一次,首页有个列表叫“没看过”,每个人看到的都不一样。
上线第三天,数据库请求已经从一天三千涨到十七万八;第四天,免费额度用完,网站挂了二十分钟。
最快的修法是多花钱。
我问的是:我们真的需要“没看过”吗?不需要。砍掉它,问题就没了。
两次,改变结果的,都是换了一个问题。
这种问题,不在任何提示词模板里。
它会在哪坏
要查什么
为谁做
什么叫好
两种“知道”
激励和约束
你一动手会发生什么
那这些判断从哪来?为什么课上讲了,很多人还是学不会?
再往下一层,是判断的来处。这里有两种“知道”。
第一种,叫世界模型。这是AI和决策领域的一个词。
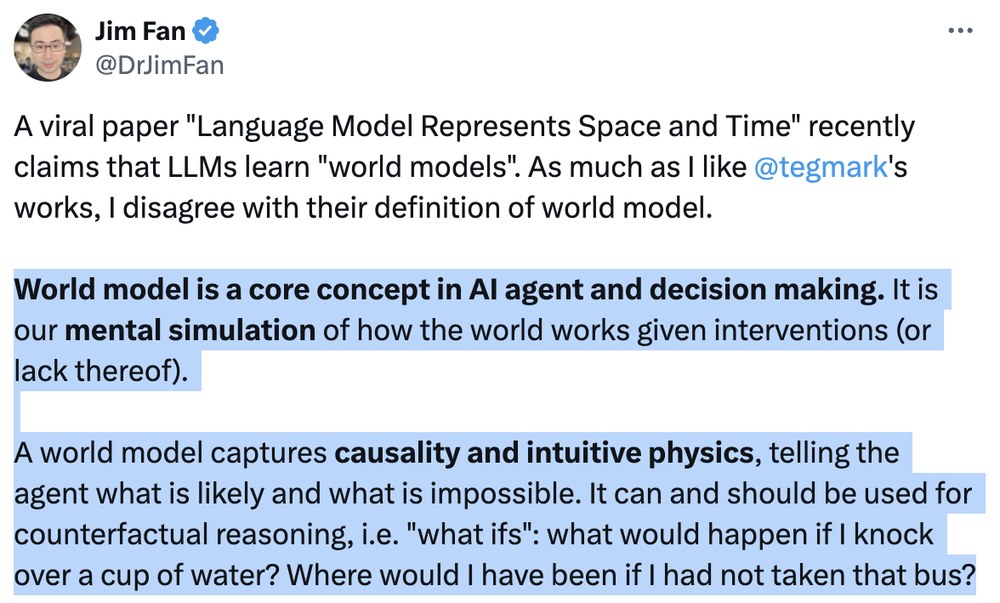
对世界如何运转的模拟
Jim Fan把它说成:我们脑子里,对世界如何运转的模拟。
我会补一句:它是你自己对原因、激励和约束的理解。什么可能,什么不可能,如果这样做,会发生什么。
比如:如果这个技能便宜了十倍,我的工作会怎样?如果停掉补贴,谁还会买?
刚才那个“没看过”,就是一个例子。我为什么会问“真的需要它吗”?
因为我脑子里有一个很简单的模型:每个人看到的列表都不一样,每来一个人,就得把所有问题重排一遍。成本,就是问题数乘以访客数。
来的人越多、问题越多,它只会越来越贵。看清了这一层,多花钱就不是解法,砍掉才是。
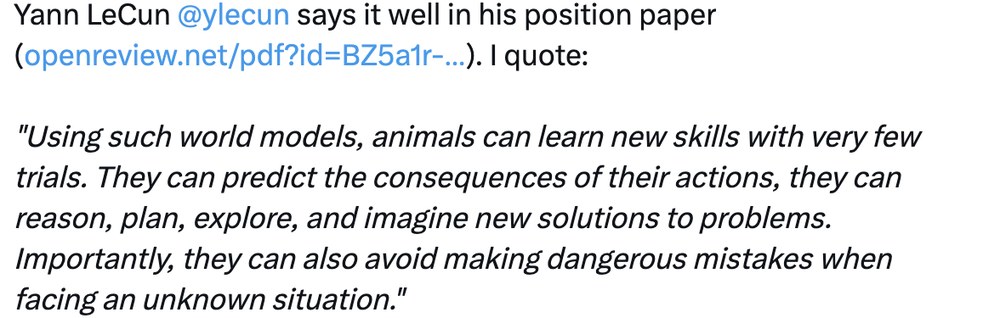
碰到从没见过的情况,也能避开危险的错误。
Yann LeCun说过,有了世界模型,动物只要很少几次尝试,就能学会新技能;碰到从没见过的情况,也能避开危险的错误。
所以想要更好的判断,更多的信息帮不了你,更多的工具也帮不了你。你得长你的世界模型。
那怎么长?做预测。
把你的判断写成会错的样子:会发生什么,概率多大,什么时候见分晓。预测会把你藏着的假设拉到明处,让现实有东西可以打分。错了,就更新。
错了不是失败,含糊到永远不会错,才是失败。
这件事真做得到吗?
2023年3月,GPT-4发布之前,我写下六个关于未来两年的判断,每个都标了概率。
后来,大概率的中了,小概率的没中。这正是你给事情标概率时,希望看到的样子。
切成碎片去检索:找得到“谁说了什么”,答不出“这三年是怎么变的”。
“不是能力不行,是它根本没有一个完整的全景图可以从中提出判断。”
鸭哥也是这么做的。前面说我没搭复杂的检索系统,不是拍脑袋。2025年4月,鸭哥做过一个实验,发现把资料切成碎片去检索,找得到相关的话,却丢了要理解的关系。所以我们一直建议,先试markdown加搜索,让AI按需去读。
背后是同一套方法:先看清一项技术到底解决什么问题,再跟最合理的替代方案比。这套方法,你也学得会。
我们把这些判断和背后的推理都写出来,标上日期。你不用从零开始,可以先借来用,再拿你自己的现实去检验它。
它会在哪坏
要查什么
为谁做
什么叫好
两种“知道”
激励和约束
你一动手会发生什么
就已经看得见
另一种“知道”,是手艺:你还说不清,就已经看得见。
鸭哥看代码,常常一眼就知道问题出在哪。我问过他,这一眼是怎么来的。
他说学生时代,每年写几十万行代码,那时候没有AI,一个字一个字敲出来的。
他也说,光看代码量说明不了什么。他自己的解释是吃过见过:见过设计得好的东西,才知道眼前这个哪里不对。
- 代码让AI写,同样的时间多做几遍、多碰几次现实
- 卡住的时候,有人一眼看出问题在哪
听到这儿,你可能会想:鸭哥这么厉害,那我怎么学?
我给一位学员写点评时说过:我们在教课的时候,我最注重的,就是把鸭哥脑子里的隐性知识显性化。但我们也发现,必须要上手,自己体验一把,才能建立这种直觉。
所以分两半。能说出来的,我们尽量说出来,做成课,比如为什么不教RAG,什么时候不该用AI。你不用也去敲几十万行代码。
说不出来的,你得自己上手。好在代码可以让AI写,同样的时间,你能多做几遍,多碰几次现实;卡住的时候,有人一眼看出问题在哪。
为什么非得自己上手?我在《真本事》里写过:学校里,考试总有标准答案;真实世界,几乎没有。
水面上的,是有标准答案的那部分,正好是AI最擅长的。水面下的没有标准答案,所以没法直接交给你。
AI是门手艺,像游泳。
你坐在菲尔普斯旁边,看他训练一万个小时,下水还是会沉。
水面下的东西,只能做出来。
可问题来了:既然只能做,为什么大多数人知道了,也不去做?
因为知道该做,和真的去做,中间隔着一股劲。
感觉像在进步,其实没有。
没有敌人可打,也没有地方可逃
这股劲,常常漏到两个地方。
一个是“看”。这个月你看了多少AI视频?感觉像在进步,其实没有。
很多人以为自己在学AI,其实是在买“我没有落后”的感觉。你买到的是接触感,不是能力。
另一个是焦虑。焦虑是大脑跑在身体前面:你在想一个还没发生的坏结果,可是没有敌人可打,也没有地方可逃,这股劲就在身体里空转。
V1三个接口串起来
V2让模型决定一切
V3固定步骤交给代码,
AI只管对话
那劲从哪来?有一部分,藏在认知里。
我们AI Architect课上有位学员,给五岁的女儿做识字助手。第一版,每回答一次要等四十秒,女儿等到第三秒就走神了。
第二版,降到将近十秒,可只有七成时候能用。
第三版,把固定的步骤交给普通代码,AI只管对话:不到三秒,而且稳定。
他不是一开始就做出第三版的。第一版和第二版,本来就是用来扔的。你要是觉得第一版就得做对,你根本不敢开始。
工具也一样。它粗糙、老出错的时候,你要知道:这说明时代还早,不说明你不行。知道这一点,卡住了才不会停。
一小件
发出来
你在发之前,你想象的所有东西全都是错的。”
还有一部分,来自具体。抽象的东西让人焦虑,具体的东西不会。
把一件大事,切成今天就能做完的一小件。做完,发出来。
我在一次大师课上说过:全都是你在发之后才有用的。你在发之前,你想象的所有东西全都是错的。
劲不耗在原地打转上
不用走的弯路,一步不走。
最后一部分,来自旁边有人。一个人摸索,要转很多圈;
卡住的时候有人一眼看出来,劲就不会耗在原地打转上。
该自己走的路,一步不少;不用走的弯路,一步不走。
所以AI来了以后,一门课到底该上什么?我的答案是三件事。
第一,把高手水面下的决定摊开给你看:他为什么这么选,在哪里差点选错。
第二,让你在自己的真问题上动手,让现实给你打分。
第三件,是给你做下去的劲:一个今天就能做完的小闭环,卡住时有人带路,做完了有人回应。
我们自己的课也照这个来:每一节都是一个小而真实的闭环,做完,发出来,讨论。
我自己卖课,所以也给你一个检验我的标准:
上完一门课,你手里有没有多出一个做完的东西?
有没有一次卡住以后,自己接着往下走?
都没有的话,这门课至少没给你劲。
你可能会说:AI自己的判断也越来越好了。对,而且还会更好。
可它的判断再好,也装不进你的脑子。你要用好它,先得能挑它给的答案;能挑,靠的还是你水面下的东西。
反过来,如果你已经能自己选问题、自己判断哪里坏了,身边还有高手给你反馈,你可能根本不需要上课。
如果你只是想买一份“没落后”的安心,也别上。
回到开头那个问题:AI都会教你了,为什么还要上课?
如果一门课只给你答案,那确实不用上了。
AI让答案几乎免费。一门课要上的,是AI给不了的两样:水面下的判断,和把它练出来的那股劲。
这一角不放要紧的东西