A/B实验是获得证据最可靠的方式
A/B实验背后的概念是随机对照试验(randomized controlled trial,RCT),它是寻找因果关系的黄金标准。
下面是著名的证据等级金字塔。基本上,唯一比RCT更强的证据形式,就是对多个RCT做的元分析。争论的时候拿出一个RCT,争论基本就结束了。
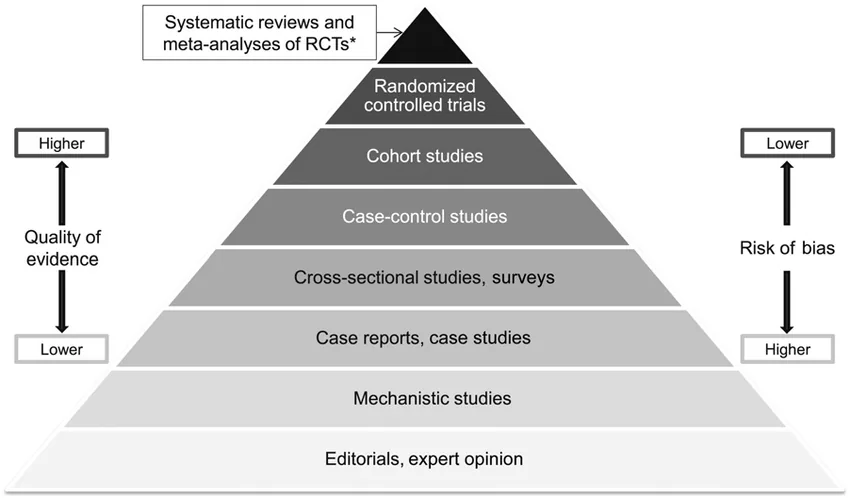
RCT的威力来自两个技术上的洞察:
- 样本足够大的时候,随机化会把偏差抵消掉。这就是大数定律。它保证了在大样本下,我们不需要操心两组在可观察和不可观察的变量上有什么差别,随机化会替我们处理好。
- 在随机分组的前提下,实验组和对照组之间的差异是由处理造成的。
「由处理造成的」,这是一句非常强的话。在大多数比较里,也就是没有RCT的研究里,两组之间的差异通常是选择偏差造成的,而不是处理造成的。
举一个简单的例子,顺便说明什么是「随机分组」,以及它为什么重要。
用一个例子理解处理效应
假设我说我有一种神奇的药丸,一颗100美元,能让高中生一年多长1英寸(约2.5厘米)。我给你看我研究里的两组真实结果:
- 实验组:1000名一年前自愿吃了这种药的学生。一年前他们的平均身高是60英寸,今年是62英寸。
- 对照组:来自同一批学校、年龄相同的1000名学生。一年前他们的平均身高是60英寸,今年是61英寸。
我们能得出结论说这药有效吗?大家都知道这种神药不存在,但这个研究的漏洞在哪里?
漏洞是「选择偏差」。实验组里的人是(自己)选择进来的。自愿参加的人可能来自更富裕的家庭,因为他们买得起药;或者他们更想长高,除了吃药还试了别的办法。任何一个这样的因素,都会破坏这个研究里的因果关系。
但如果我们有2000名学生,随机决定谁吃药,就消除了选择偏差。根据大数定律,两组的各项平均指标(身高、家庭财富、身高的增长、想长高的程度,等等)应该是一样的,两组身高增长的差异就一定是由处理,也就是这颗药,造成的。
产品开发里的选择偏差
把这个例子放到产品开发里,就能看出,如果没有A/B实验的思维方式,我们每天都可能犯这样的错。比如:
时间序列上的选择偏差:
- 说法:我们上线了一个功能,指标涨了10%。
- 现实:没有这个功能,指标也会涨10%。比如在黑色星期五之前上线一个黑五活动的横幅。
横截面上的选择偏差:
- 说法:我们上线了一个功能,用了这个功能的用户,指标涨了10%。
- 现实:自己选择去用这个功能的那批用户,没有这个功能,指标也会涨10%。比如给重度用户加一个按钮(参考:为什么大多数aha moment都是错的?)。
A/B实验是一种强大的衡量手段
除了因果,A/B实验本身也是一种强大的衡量手段。彼得·德鲁克说过:「无法衡量,就无法改变。」在管理摩擦很多的大公司里,这一点尤其明显。
我们和Rec Room的客户案例就是很好的例子。他们做了一次很漂亮的界面改版,结果核心指标下降了30%以上。没有A/B实验,他们根本不会注意到。
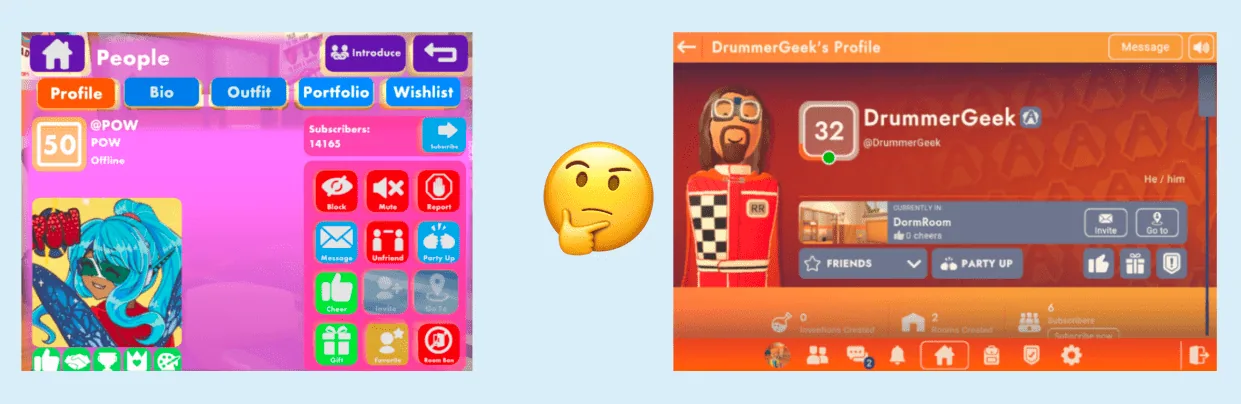
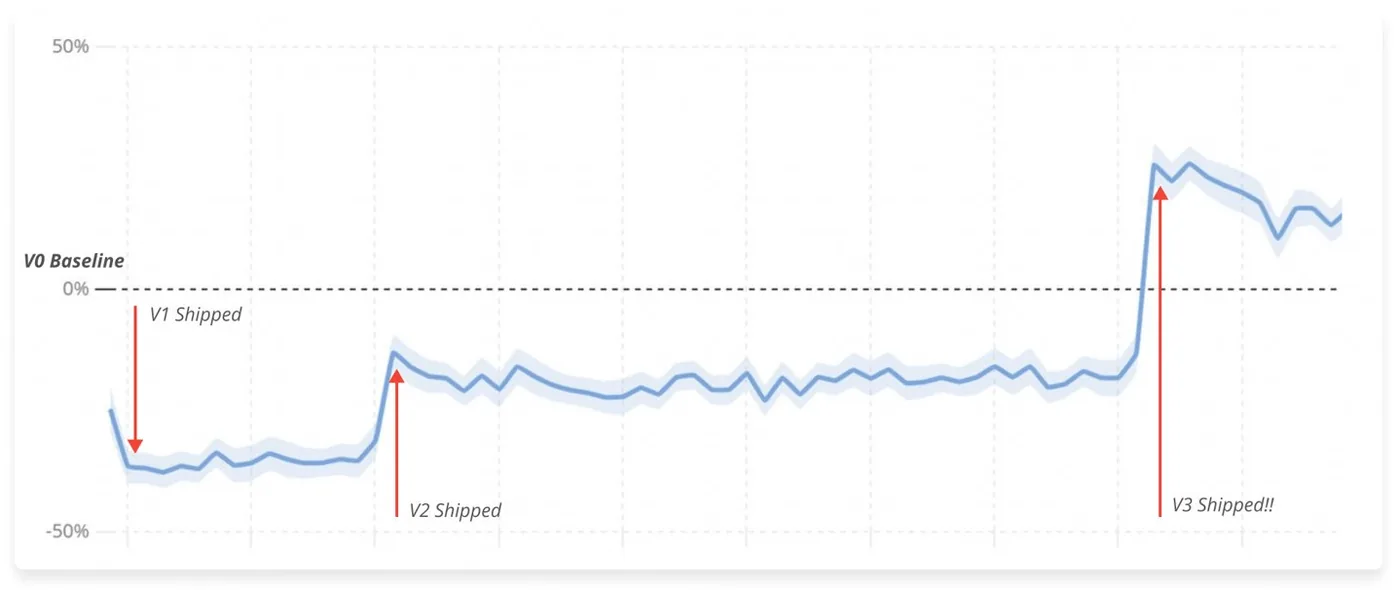
产品开发不是一锤子买卖,而是一个持续迭代、积累小胜利的过程。可如果你没法把赢和输区分开来衡量,你就赢不了。人们一开始做A/B实验就会发现,自己70%到90%的想法其实是没用的。
所以,不做A/B实验的人,会在不知不觉中上线很多坏想法。
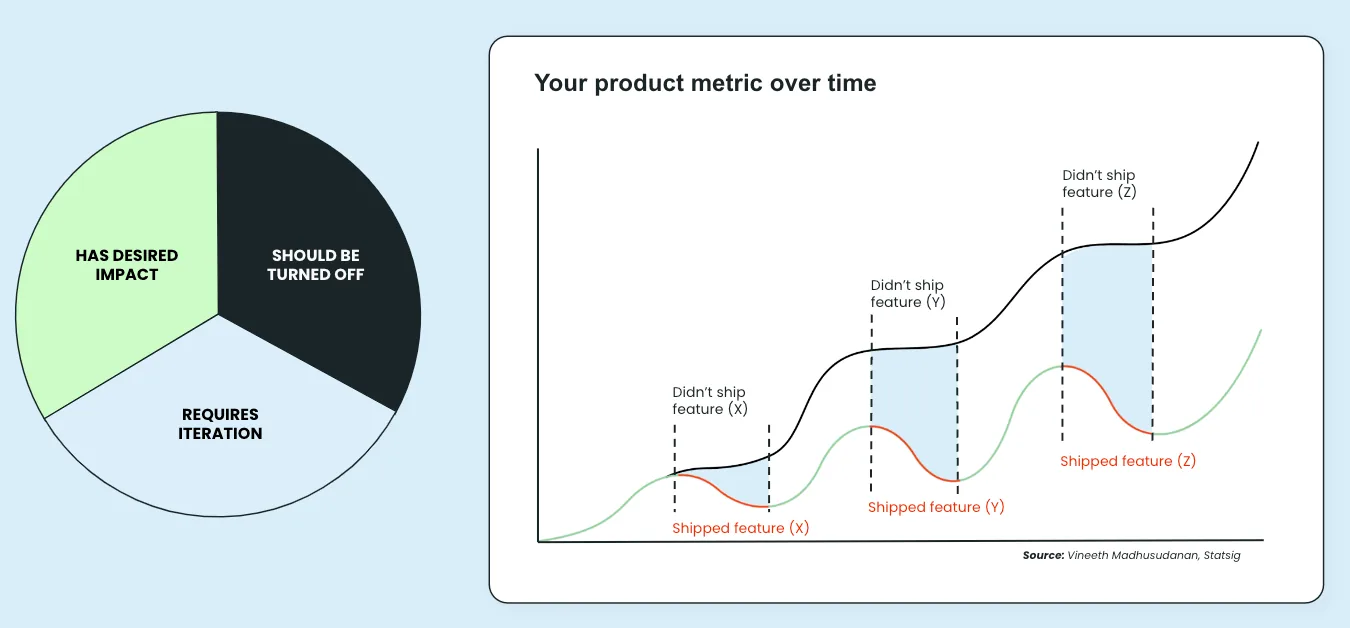
简单说,A/B实验之所以强大、重要,是因为:
- 人很不擅长归因,而且受各种偏差的影响;
- 人很不擅长预测自己的想法会带来什么结果。
A/B实验提供了必要的衡量和因果,让我们对现实保持诚实。
这是Statsig博客英文原文的中文版。原文发表于2024年9月5日,中文版发布于2026年10月4日,图表来自原文。看全部19篇