实验在产品增长中的作用
实验让团队从洞察走到行动
前面几章讲的是怎么深入数据,找到增长机会:产品哪里做得好,哪里还能优化。但找到机会只是开始。要有把握地推动增长、让团队对齐,就得用扎实的证据验证你的假设。这就是实验,尤其是A/B测试的作用:让你从洞察走到行动。
有用的分析,都是因果分析
你可能会问:预测模型、growth accounting、漏斗分析,看的不都是相关关系,而不是因果吗?没错。但作为数据分析师或数据科学家,你最主要的责任,是给出清楚的因果判断。你要能说:「根据我的分析,我建议做A而不是B,因为我认为A能带来更多用户、更高的参与度,或者更多收入。」本质上,你是在说:「这个改动会导致那个结果。」
所以,所有有价值的分析,最终都是为了说明一个因果关系。有强的因果证据,路就很清楚;没有,你就有责任搭出一个有说服力的论证,说明你的建议会给业务带来正面的影响。
数据很有说服力,但前提是讲得清楚、推理站得住。这就是为什么实验对产品增长这么关键,尤其是随机对照试验,也就是A/B测试的黄金标准。它能为你的决定提供最强的证据。收集洞察还有别的办法,但只要条件允许,就把实验当作默认的选择。
随机对照试验和因果推断:快速入门
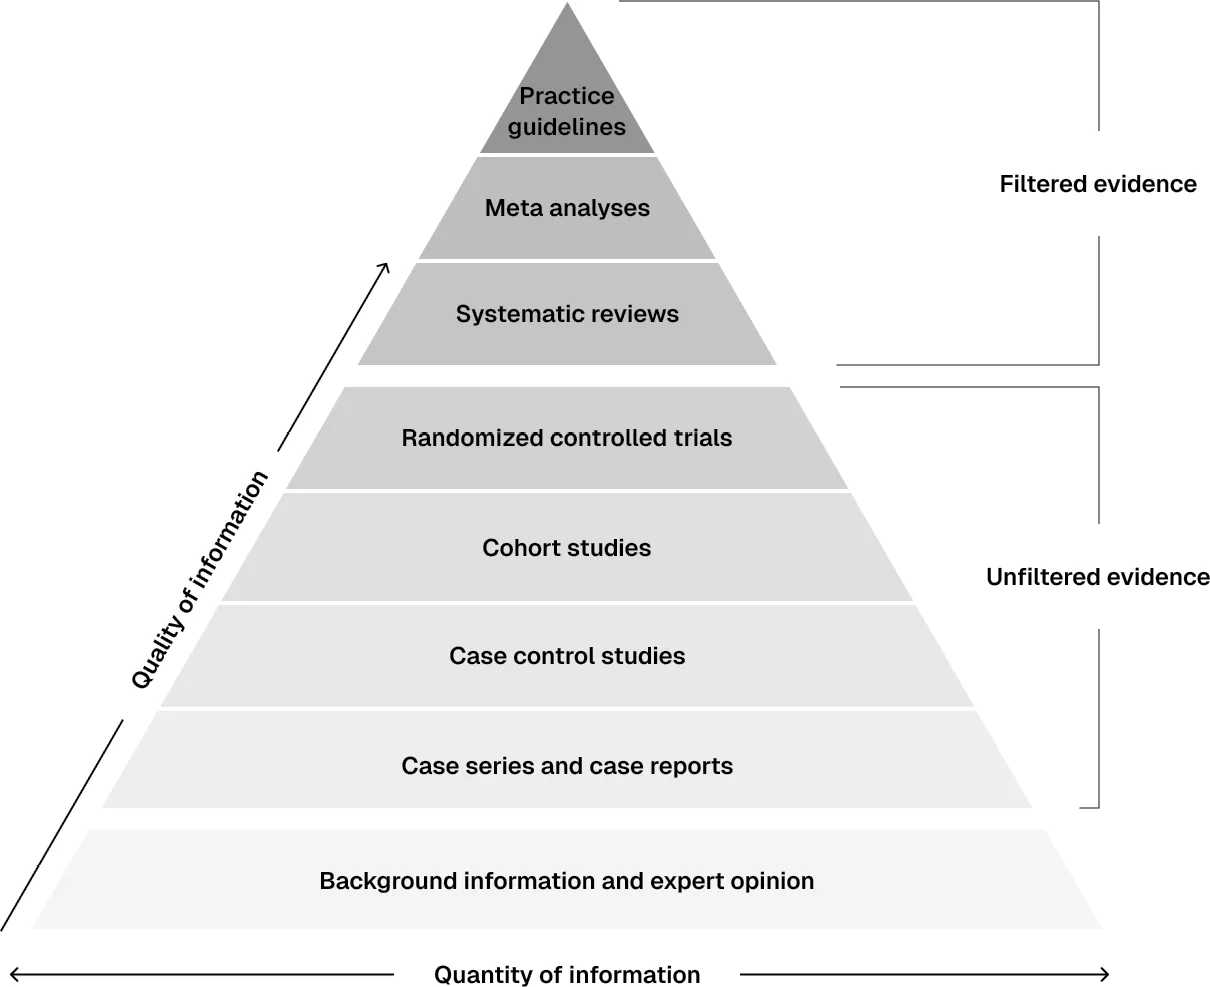
证据金字塔按证据的强度和可靠程度,给不同类型的研究排了序。1在未经筛选的证据里,最顶端是随机对照试验(RCT),被认为是最严谨的一种。做得好的A/B测试,结论应该优先于其他形式的证据,因为它最可靠。
举个例子。你想把行动按钮(CTA)上的文字从「购买」改成「立即购买」,希望提高转化率。按证据金字塔,一步一步来:
- 专家意见:问问专业人士,这个改动可能有没有用。
- 案例研究:看看其他公司改按钮文字的案例。
- 数据分析:系统地分析数据,比较写着「购买」和「立即购买」的按钮表现有什么规律。
- 队列研究:把按钮从「购买」改成「立即购买」,比较改动前后的转化率。
- 随机对照试验:随机让一半用户看到「购买」,另一半看到「立即购买」,比较两组的转化率。
每往上一步,都是在解决上一步可能的偏差:
- 从专家意见到案例研究:专家可能会错,也可能有偏见,所以要从真实的案例里找规律。
- 从案例研究到系统比较:案例未必适用于你的客户和你的情况,所以要做更广泛的比较。
- 从比较到队列研究:单纯的比较,没法判断结果的变化是来自改动,还是来自季节、外部事件这些别的因素。
- 从队列研究到随机对照试验:只有随机对照试验,比如A/B测试,才能真正控制住所有的变量。分组是随机的,两组之间的差别就可以放心地归到改动本身上,在这个例子里就是把「购买」改成「立即购买」。
A/B测试有效,靠的是两条原理:
- 随机分组:一组看到改动(「立即购买」),另一组保持不变(「购买」)。因为分组是随机的,两组在年龄、收入、身高这些特征上没有系统性的差别,所以结果上的差别,可以归到改动本身,而不是其他因素。剩下的随机波动,用统计检验来衡量。
- 大数定律:样本足够大时,随机分出来的两组,各项特征的平均值(比如年龄、收入、身高,以及在不做改动时的转化率)在统计上会非常接近。
A/B测试的价值在于,只要按规范的流程做,就不需要额外的假设。认真地做实验,拿到尽可能可靠的证据。能做A/B测试,就做。它是基于证据做决定的黄金标准。
实验成功的关键因素
成功的增长团队都很会用二八法则:20%的努力带来80%的结果,把精力放在关键的少数,而不是琐碎的多数。做实验也一样。下面这些是关键:
- 清楚的假设:想清楚你在测什么、为什么测。
- 扎实的基础设施:
- 分组均衡:实验组和对照组真的可比;
- 埋点准确:准确、有效地记录相关数据;
- 设置简单:能快速、轻松地建一个实验;
- 指标全面:能高效地监测大量指标。
- 实验文化:
- 对想法开放:每个人都能提出实验;
- 一起做决定:团队一起决策,而不是自上而下地下命令;
- 谦逊:接受大多数最初的想法达不到预期;
- 重视学到的东西:不管实验「成功」还是「失败」,都总结学到了什么;
- 迭代:根据实验结果不断改进产品。
统计上的细节很重要,但值得单独讲,比如可以读《关键迭代:可信赖的线上对照实验》(Trustworthy Online Controlled Experiments)。这一章不陷进去,只讲大图景:可规模化的实验是什么,为什么它能改变产品增长的玩法。要理解实验为什么重要,先要认识到,最初的想法有多常出错。
接受自己会错:为什么大多数想法一开始都会失败
人们怎么看待自己的想法,差别很大。经常做实验的人,对自己最初的假设很谦逊,因为他们亲眼见过这些假设有多常落空。研究显示,在各种公司和团队里,大约80%的最初想法达不到预期的效果。2相反,很少做实验的人,往往会高估自己想法的成功率。
接受这个事实并不容易。为什么会这样?主要有两个原因:
- 在解难题:如果想法大多数时候都成功,说明我们在解的是简单的问题。但产品增长处在产品开发、市场营销和行业最佳实践的最前沿,没有哪个想法能保证第一次就成功。
- 现代产品太复杂:今天的产品所处的生态极其复杂,超出了人脑同时把握所有方面的能力。
第一点很直观,第二点更微妙。用DDT和白头海雕的故事来打个比方。
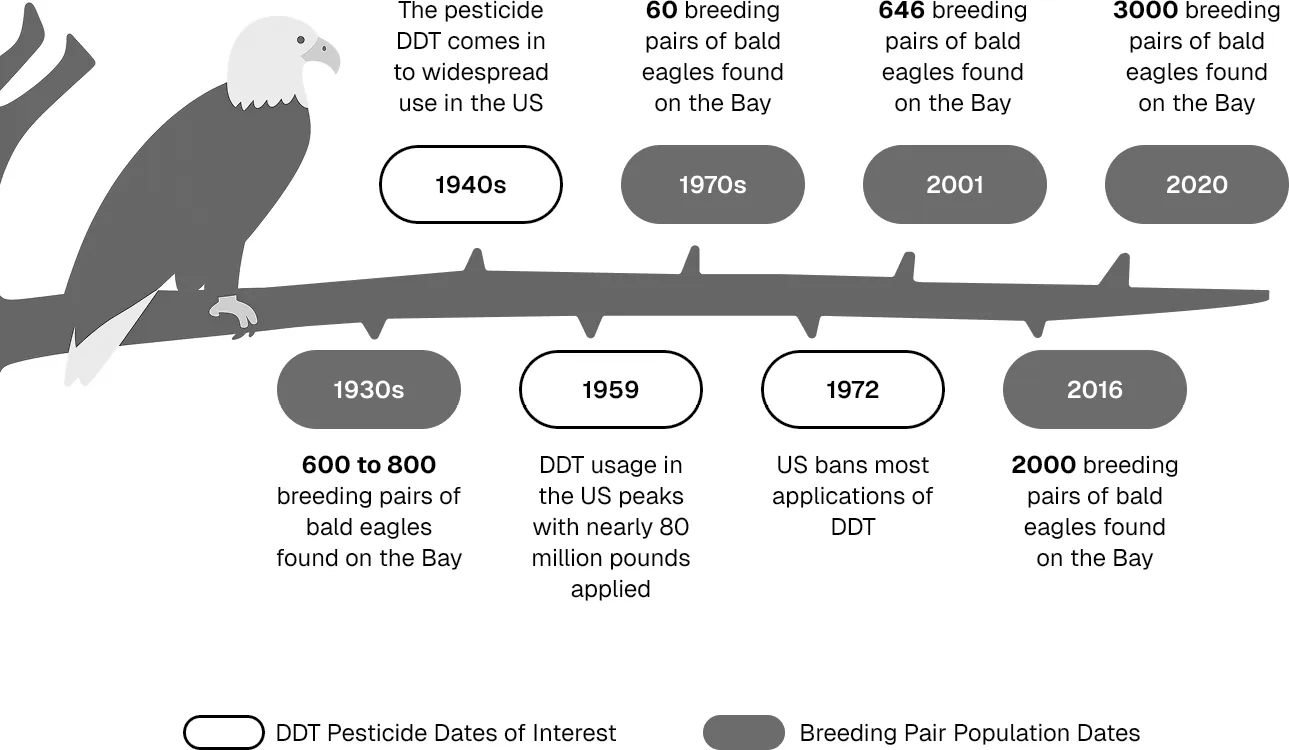
20世纪40年代,DDT被当成一种突破性的杀虫剂,效果惊人。经过大量研究,当时的科学家认为它对环境没有什么大的风险。
可后果在多年以后才显现。白头海雕吃了被污染的鱼,间接受到了伤害。DDT沿着食物链往上走,浓度越来越高,让海雕的蛋壳变薄。蛋在孵化时很容易破,白头海雕的数量急剧下降。
回头看,这个联系似乎很明显,可当时没有人能预见DDT会引发这么复杂的连锁反应。现代产品面对的情况也一样复杂:市场多样,用户需求千差万别,产品本身也极其复杂。承认这一点,就要对自己的预测保持谦逊,明白结果可能和预期差得很远。
接受了这些现实,就会明白:要实现可持续、能复利的增长,实验是必须的。弄清什么有用、什么没用、怎么改进,是成功的关键。
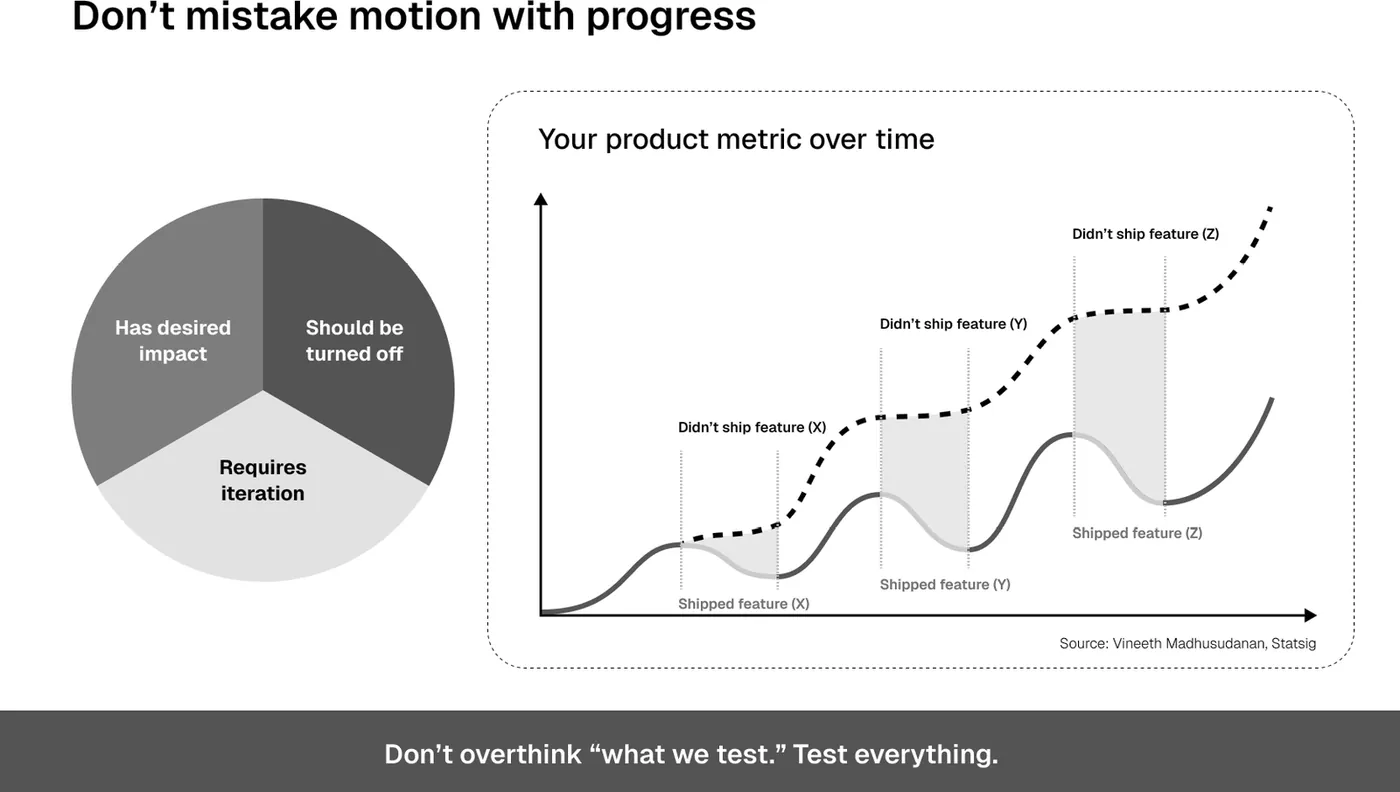
为了把实验背后的道理吃透,下面看两个真实的例子。
例子一:一次A/B测试,改变了Marketplace的方向
我对A/B测试的信念,是在疫情期间定下来的。当时我们想在一个社交app的二手交易平台Marketplace上推电商。一开始失败了,后来转了方向,最终做成了。
A/B测试揭示了失败
Marketplace看起来天然适合做电商,因为用户经常在上面买东西。我们的产品负责人来自eBay,团队里还招了Walmart等公司的人。
这些团队进了作战室,要在Marketplace上做一个电商优先的体验。
我从Amazon过来,对这件事很兴奋,心甘情愿地熬了很多个通宵。
第一个大的上线放在主标签页上,设计考虑得很周全:现代的视觉,顺畅的结账流程,专门的团队挑选有吸引力、又相关的商品。我们还用补贴把价格做到和竞争对手一样,退货政策也很宽松。
好在这次上线我们做了A/B测试。结果是一场灾难,所有人都震惊了,包括我。
几乎每个指标都在下降:从商品详情页到结账的转化率,从浏览到商品详情页的点击率,浏览的曝光次数,还有日活。
结论很清楚:Marketplace的用户讨厌我们上线的东西。
失败通常有两种原因:要么想法本身有问题,要么执行出了问题。领导们自然会怀疑执行,这也合理。我自己也在怀疑我们的执行。
用实验分析失败
幸运的是,另一个实验帮团队避免了在一个注定失败的想法上继续投入,也避免了为它的失败背锅。
这个实验要提供强有力的证据,证明电商在Marketplace上就是行不通。我们的假设是:Marketplace的用户是来淘便宜货的,他们对一般的电商商品没兴趣。
事后看,这很合理:既然有Amazon,用户为什么要在一个社交app里买电商商品?可是,怎么说服那些下定决心要在我们平台上把电商做成的人?
白底图的影响
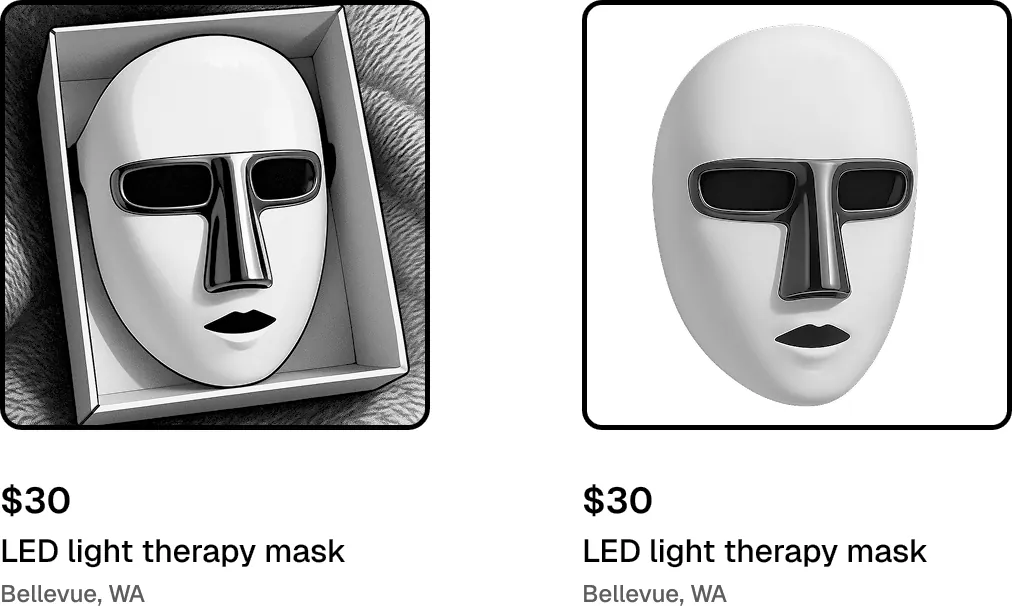
我们发现,大多数「Marketplace原生」的商品,图片都带着真实的场景,比如把东西放在桌子上拍;而大多数电商商品用的是干净、专业的白底图。
为了验证,我们拿同一批商品,在浏览信息流里随机展示白底图或者带场景的图。结果发现,白底图让点击率和转化率都下降了:用户觉得自己像是在逛传统的电商,而不是在淘便宜货。很多人一看到白底图,就以为是广告,直接划走了。
A/B测试带来的改变
这件事让我对A/B测试的意义有了很深的体会。
白底图实验之前,我经历了无数场会议,争论哪个想法会成功,谁该为糟糕的执行负责,流程该怎么改进。
白底图实验之后,这些争论很快就结束了。我们把力气转到让Marketplace上的本地商品支持邮寄。接下来六个月,Marketplace上的线上交易增长了26倍,超过了同类社交购物app的总和。
如果没有这两个实验,很多人的职业甚至生活都会受到负面影响。
在这类故事里,领导有时会被讲成反派:战略不对,决策失误,不懂业务,把锅甩给下属。
但老老实实复盘以后,我发现自己的看法也是走到一半才变的。当你全身心地想把一个想法做成时,很难看清现实。
对我来说,这就是因果证据和A/B测试真正的力量:我相信,就算是扎克伯格本人来说服我,也不会比这两个实验更有效。
例子二:降低视频画质,能增加收入吗?
Facebook前副总裁、娱乐业务负责人Vijaye Raji讲过一个很有意思的故事:一个看起来是负面的画质改动,带来了意想不到的正面结果。它说明了实验和挑战既有假设在产品开发中有多重要。
疫情带来的难题
疫情期间,人们转向视频来娱乐和保持联系,网络用量大幅上升。这给网络基础设施带来了很大压力,甚至威胁到一些必要的线上服务。各国政府和电信公司呼吁视频平台减少带宽占用。
反直觉的方案
Vijaye带的工程团队决定做一个实验:降低视频画质,减少带宽使用。他们想量化画质下降对观看时长和广告收入的影响。大家都预期会下降,因为整个组织长期以来都相信用户更喜欢高画质,过去的实验也一直显示,画质越好,观看时长和广告收入越高。
意外的结果
结果出乎所有人的意料。带宽确实如预期那样下降了,可观看时长和广告收入不但没降,反而都上升了。这个反直觉的结果引出了更多的问题:难道整个组织一直都错了?那些为了提升画质投入的工程和硬件资源又算什么?
根本原因
在有些组织里,领导可能会选择无视负面的结果,或者把它埋掉。好在Vijaye把弄清真相放在第一位。他组建了一个专门的数据科学团队来调查。团队仔细分析实验结果,再和其他分析对照,很快找到了根本原因。
原来,疫情期间,很多用户,尤其是印度这样的发展中国家的用户,手机流量是有限额的。看低画质的视频,同样的流量能看更多内容,所以总的观看时长和广告收入反而增加了。
实验的力量
事后看,工程师们能预见到流量限额的影响吗?很难。就像DDT和白头海雕的故事一样,没有人能预见所有的变量。这就是为什么要做实验。但实验要真正有价值,必须扎根在追求真相的文化里。希望这个故事提醒大家:实验能发现意想不到的洞察,推动产品增长,在快速变化的环境里尤其如此。
深入讲讲可规模化的实验
什么是可规模化的实验
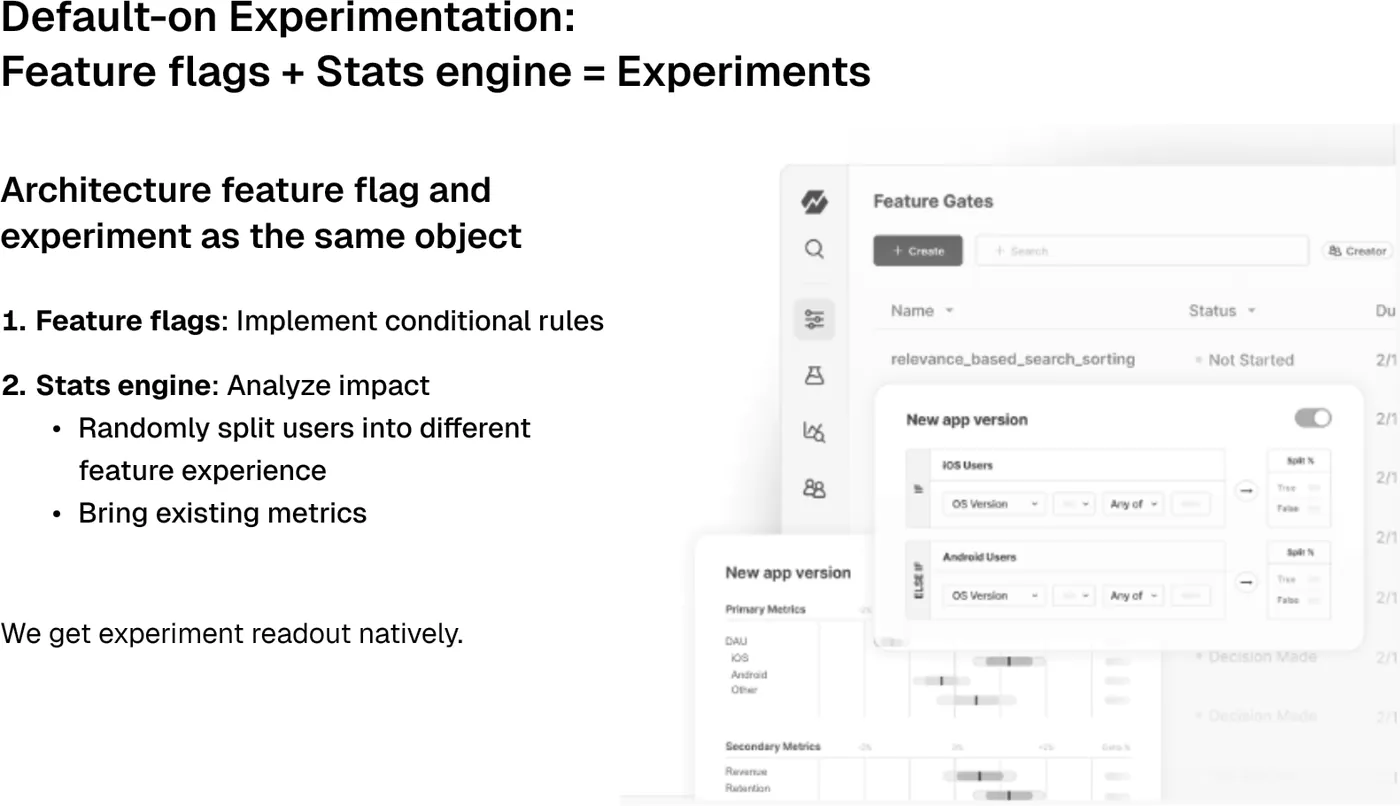
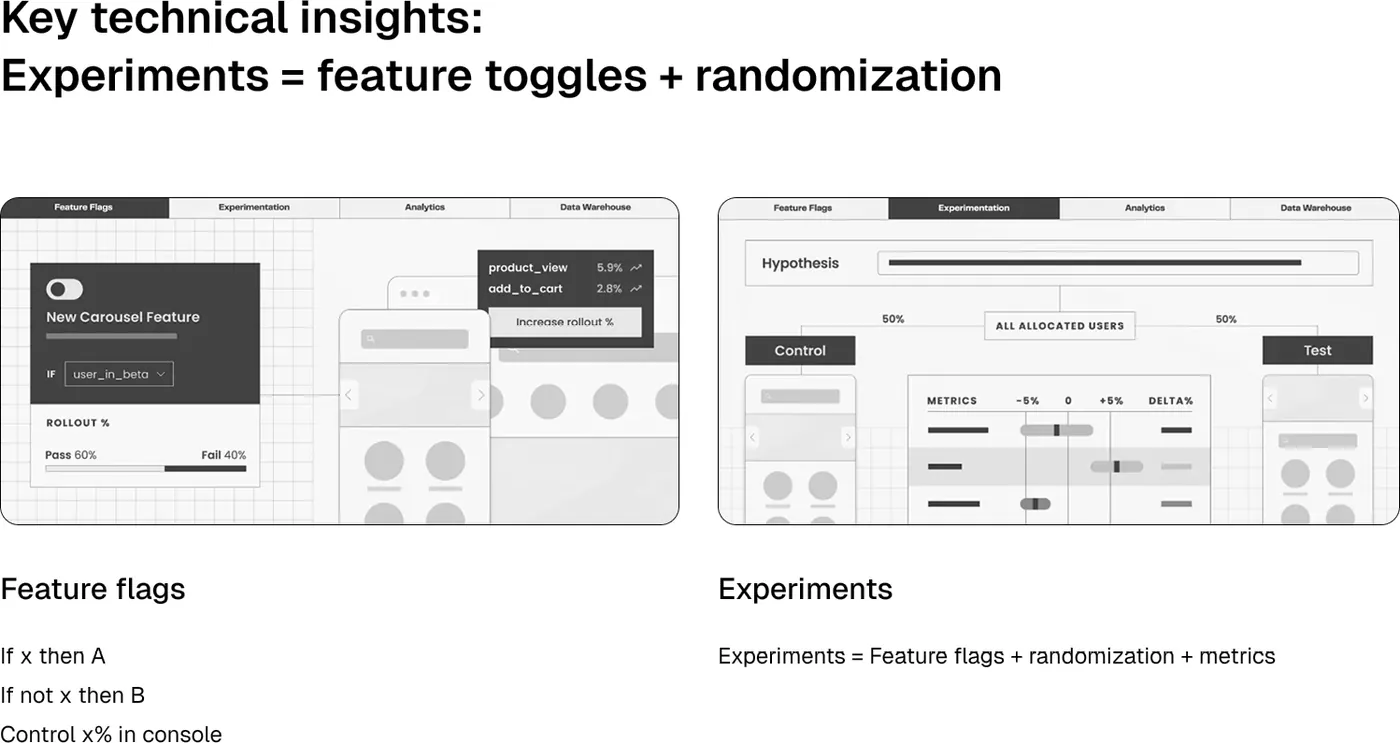
可规模化的实验,指的是让实验成为默认的做法,而不是例外。现代的软件开发技术,尤其是功能开关(feature flag)和持续集成、持续交付(CI/CD),让这件事不但可行,而且是最优的做法。
用功能开关,你可以控制一个新功能什么时候、对谁上线。这样就把「部署代码」和「改变功能的配置或可见范围」分开了,这是现代软件开发的一个基本原则。
有了功能开关,你就已经有了可规模化实验的基础:你能完全控制哪些用户看到产品的哪个版本。再加上随机分组,实验就成了常态,而不是孤立的事件。
我们总结了可规模化实验基础设施的七条标准,可以拿来评估你自己的系统:
- 指标定义一次,到处使用:不用每个实验都重新造轮子。
- 数据可靠、透明:让每个人都清楚数据是什么意思、从哪来。
- 构建、测试和部署的是同一份代码:降低上线实验时引入错误的风险。
- 建立实验文化:让实验成为团队的本能(见本章前面「实验文化」的部分)。
- 信息清楚、有层次:用容易理解的方式呈现数据,支持做出明智的决定。
- 统计引擎可信又实用:避免过于复杂、难以解读的统计方法。
- 能自动化的都自动化:埋点、健康检查、计算、实验管理,以及其他所有能自动化的事。
为什么需要可规模化的实验
实验非常有价值,但它不像用Excel记基础账目那样「非做不可」。实验是为了发现新的增长机会,而不是维持现状。它属于经典的「重要但不紧急」的事。
要把实验融入日常工作,就要尽可能清除障碍,这需要在合适的基础设施上投入。打个比方:你可以每天走很远去河边打水,也可以打一口井,给全村提供稳定的水源。打井要先投入,但长期的回报很大。
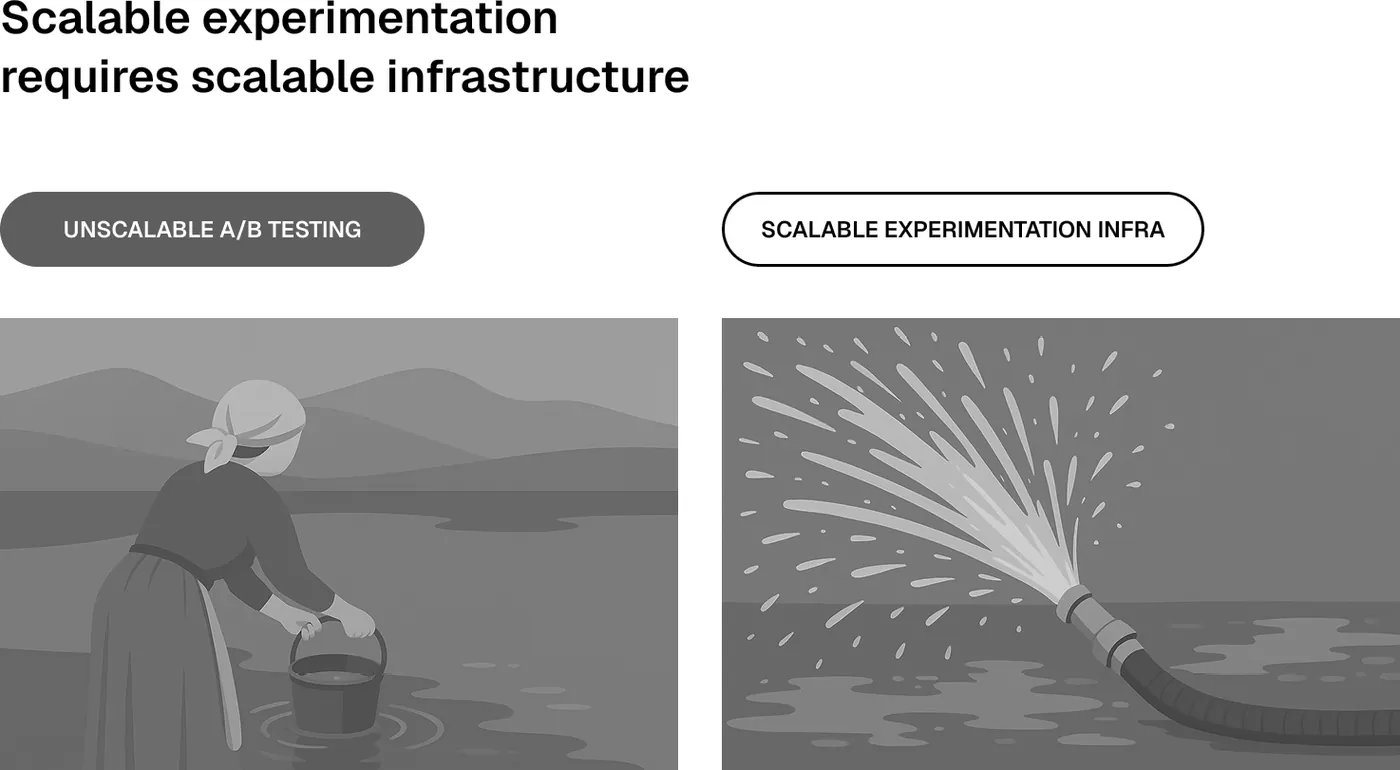
实验是一门手艺,只有在实践中才能练成。所以一定要让实验成为默认的选择。否则,运行和维护实验的时间和精力成本,会比你的能力增长得更快,实验项目最终会停滞。
本章要点
下面这张表,可以帮你开始做可规模化的实验:
| 衡量什么 | 做哪些分析 | 采取哪些行动 | 什么时候可以进入下一步 |
|---|---|---|---|
| 现有的实验能力 | 盘点现有的工具和流程;评估团队对实验的理解;找出当前流程的瓶颈 | 画出理想的实验流程;调研并选择合适的工具(功能开关、A/B测试平台);为团队准备培训材料 | 清楚现在的状态,有对未来的设想,也有弥合差距的计划 |
| 实验基础设施 | 监测功能开关和A/B测试系统的健康状况;追踪实验设置、执行和分析的关键指标 | 把实验流程尽可能自动化;为数据质量和一致性定清楚的规范 | 实验基础设施可靠、高效,能同时跑多个实验 |
| 实验文化 | 调研团队对实验的态度;追踪不同成员提出和上线的实验数量 | 营造一个可以放心分享想法、从失败中学习的环境;表彰和奖励推动实验的个人和团队 | 实验成了团队的本能,每个人都觉得自己能出一份力 |
| 实验对产品增长的影响 | 追踪带来产品改进的成功实验数量;衡量这些改进对关键业务指标的影响 | 建立记录和分享实验结果的机制;用实验结果指导产品战略和路线图的优先级 | 能清楚地说明实验和业务成果之间的联系,下一轮迭代要看的图表也都准备好了 |
表10-1 可规模化实验的快速入门
练习
你在做一个手机app,用户参与度一直在下降。团队的假设是:问题可能出在app的性能上。
问题1:实验设计。设计一个A/B测试,研究视频画质对用户参与度的影响。要考虑:
- 你会追踪哪些指标?
- 你会怎样给用户分群?
- 有哪些潜在的混杂变量需要控制?
问题2:数据分析。下面是实验的假想数据(假设样本量足够,差异在统计上显著):
| 指标 | 对照组(高画质) | 实验组(低画质) |
|---|---|---|
| 平均每次使用时长 | 8.5分钟 | 12.3分钟 |
| 每次使用的流量 | 45MB | 28MB |
| 7天留存 | 65% | 72% |
表10-2 实验的假想数据
请分析这些数据,并说明:
- 你能得出什么结论?
- 还需要哪些数据,让分析更有说服力?
- 你会怎样把结果讲给相关方听?
问题3:实施计划。根据你的发现,做一个计划:
- 怎样用功能开关实施这些改动?
- 你会建立什么样的监控?
- 怎样逐步放量?
参考答案
问题1:一个设计得好的实验包括:
- 关键指标:
- 主要指标:用户参与度(每次使用时长、留存);
- 次要指标:流量消耗、视频完播率;
- 护栏指标:app崩溃率、用户投诉。
- 分群:
- 按设备类型,看硬件差异;
- 按网络类型(Wi-Fi还是移动网络);
- 按地区,看基础设施的差异。
- 需要考虑的因素:
- 一天中不同时段的差异;
- 用户的人口属性;
- 内容类型的差异。
要说明一点:随机分组本身就消除了混杂,两组在这些因素上不会有系统性的差别。按设备、网络、地区拆开看,主要是为了看效果在不同人群里是不是不一样,就像例子二里,效果主要来自流量有限额的用户;也可以用来做分层,降低方差,让实验更灵敏。
问题2:根据数据,可以得出:
- 每次使用时长增加了45%(从8.5分钟到12.3分钟);
- 流量消耗减少了38%(从45MB到28MB);
- 7天留存提高了7个百分点(从65%到72%,相对提高约11%)。
还需要的数据:
- 用户满意度;
- 更长期的留存(30天、90天);
- 对收入的影响;
- 按网络类型和地区拆开的结果,看效果是不是集中在流量受限的用户身上。
怎么讲给相关方听:先讲结论和建议,比如「低画质让用户用得更久、留得更好,建议对移动网络用户默认用低画质」;再讲证据,也就是这三个指标的变化和显著性;最后讲风险和还没回答的问题,比如长期留存和满意度还没看到,以及下一步打算怎么验证。
问题3:一个稳妥的实施计划包括:
- 功能开关:
- 为不同的画质档位建细粒度的开关;
- 支持对单个用户手动覆盖;
- 根据网络状况自动调整画质。
- 监控:
- 关键指标的实时仪表盘;
- 异常检测的自动报警;
- 收集用户反馈的渠道。
- 逐步放量:
- 第一周:5%的用户;
- 第二周:没有问题就扩到20%;
- 第三到四周:一边监测指标,一边扩到50%;
- 第五周以后:指标一直是正的,就全量上线。
注释
University of New England,「The Evidence Pyramid」,2025年7月8日访问,https://library.une.edu/research-help/help-with/evidence-based-practice/the-evidence-pyramid/。↩︎
Ron Kohavi,「Success Rate of Ideas vs. Experiments and the Implications of False Positive Statistically Significant Results」,2023年12月10日,https://docs.google.com/document/d/1_D2IsIlR9HsdGpOg3J1g44G5VqfTkTVw/edit;Ron Kohavi、Thomas Crook、Roger Longbotham,「Online Experimentation at Microsoft」,Microsoft Experimentation Platform,2009,https://exp-platform.com/Documents/ExP_DMCaseStudies.pdf;Lenny Rachitsky在LinkedIn上转述Ron Kohavi这组数据的帖子,2023。↩︎
下载整本书
Growth Data Analytics Playbook 中文版,免费下载。